Sunday, 21 August 2022

The Skills of Encouragement


The Skills of Encouragement

Bringing out the Best in Yourself and Others

Dr. Don DINKMAYER

Dr. Lewis LOSONCY

The Skill and Process of Getting High on Yourself

1.       1-   Listen and attend to others.  When you are in contact with them, stop your preoccupation with what you are doing.  Listen and be in a position to hear the whole message.

2.       2-     Before you talk with others, clarify the message they have sent to you. “I hear what you are saying, feeling, etc.”

3.       3-     Use put-ups instead of put-downs.  What are somethings  you could do to help build the other person’s self-esteem.  What could you say that is positive?

4.       4     Respond reflectively, while continuing to stay with the other person’s feelings.

5.       5-     Look for similarities.  What do the two of you have in common?  Where are some places you can universalize?

6.       6    Give them feedback on how they are coming across to you.

7.       7    Encourage them for their strengths and not their perfections.

8.        8   Help them to see perceptual alternatives or more positive, effective ways they can look at the world(page 31).


 Listening involves giving your full attention to the person you are with.  It involves not only the content but the feelings, beliefs, and attitudes.  The skilled listener then moves to communicating the beliefs, feelings, and attitudes that he or she is hearing.  Through the simple process of listening, being heard, and processing feedback, the other pserson starts to feel encouraged and valued (page 36).


Wednesday, 8 June 2022

LanganaT ne yapabilir, ne yapmalı?

 LanganaT ne yapabilir, ne yapmalı?


1-Bir referans dosya ya da kitabı önceden batch olarak PARSE eder.
Özne ve nesneleri belirler.
2- Gelecek soruyu online olarak alır ve PARSE eder.
Özne ve nesneleri ayırır, soruyu belirler.
3- Soruya göre, örneğin bisikleti ilk kim yaptı? sorusuna göre,
arama metnini lokalize eder.
4- Odaklandığı metinler içinde bisiklet ve buldu kelimelerini
arar, o cümlenin öznesini bulur.  
5- Bulduğu özneyi özel isimler listesinde kontrol eder.
6- Özneyi, soru cümlesinde 'kim' kelimesi yerine yerleştirir
ya da yeni bir cümle yapar ve soruyu cevaplar.

Bu mantık herhangi bir uzmanlık alanında çok kalın kitaplardan
bilgi çıkartmak için kullanılabilir.

Örneğin (İzmir Ege Tıp fakültesi hastahanesi başhekimi Adil ESEN (AFL78)
üroloji için hazırladıkları bir kitap metnini göndermişti bana.
Bu metnin işlenmesi Tıp deyimleri sözlüğünü gerektirir.  Fakat
LanganaT PARSER'ı otomatik tarama ve bilgi bulma amacıyla kullanılabilir.)
Aynı mantık, İngilizce bir PARSER olmak şartı ile Uçak Bakım
sürecinde bakım süresini kısaltmak için kullanılabilir ve ekonomik
olarak çok yüksek artı değer getirir. (Yaptığım İngilizce tercüme
motorunda çok gelişmiş olmasa da bir İngilizce PARSER var).

Anlamak bilmekten daha geniş ve derin bir kavram.
Bisikleti kim icad etti? sorusu Bisikleti ilk kim yaptı?
Bisikleti kim buldu?  Bu üç soru da doğru ve aynı cevaplanmalı.

Bu bir eş anlamlar sözlüğü, deyimler sözlüğü ve nihayet bir
thesaurus ve semantik sözlük gerektirir.  Çok sınırlı bir deyimler sözlüğü
kullanıyor LanganaT.  Sözlüklerin hazırlanması ise güçlü tarayıcı ve
bulucu programlar gerektiriyor.

Bu programların geliştirilmesi için ise Türkçe CORPUS oluşturmak gerekiyor.
Corpusların seçilecek konuya hatta üsluba (gazete makalesi, bilimsel makale) 
göre de seçilmesi gerekiyor.  Elimde 1 milyon kelimelik sınırlı bir edebi 
Corpus var.  Bunun içinde bile dilin eskiliğine ve yazarlara göre farklılıklar var.
 
AMAÇ: Büyük verilerin içerdiği metinlerin kolaylıkla işlenmesini sağlayacak
araçlar geliştirmek.  Örneğin bir kuruluşun (bir banka, silahlı kuvvetler,
Facebook, internet yazıları) bütün iletişimlerinin izlenmesi ve istenen
sorulara cevap bulunması.  Bu işlemin yüzlerce seçenek oluşturan anahtar
kelimeler yerine daha sınırlı anlamsal şekilde ve çabuk gerçekleştirilmesi.
Nihai hedef, bir insanın zihinsel işleyişine benzer yaklaşımlarla OTOMATİK ANLAMA.


Tuesday, 8 December 2020

LANGANA-T artık okuduğunu anlamaya başladı

İyi haber!

LANAGANA-T aşağıdaki yazıyı okuyup yazının ne olduğunu anlayabiliyor.


-------------------------------------

 Deniz Yıldızının Hikayesi

  Bir adam sabaha karşı okyanus kenarında yürüyormuş.  Birden binlerce deniz yıldızının karaya vurduğunu görmüş.  Daha da yaklaştığı zaman bir çocuk fark etmiş.  Çocuk deniz yıldızlarını tek tek alarak denize geri götürüyormuş.

  Adam çocuğa yaklaşarak sormuş:

 -Bu deniz yıldızlarını neden denize geri atıyorsun?  

  Çocuk cevap vermiş:

  -Güneş yükseliyor.  Birazdan sular çekilecek ve bu deniz yıldızları susuzluktan ölecekler.

 Adam bu duruma şaşırmış:

  -Sahil çok uzun ve çok fazla deniz yıldızı var. Hepsini kurtaramazsın. Ne fark eder ki?

 Çocuk adamı dinlemiş.  Daha sonra sahilden bir deniz yıldızı daha alarak denize bırakmış. 

 Sonra adama dönerek:

 -Bak görüyor musun bu deniz yıldızı için fark etti demiş.

---------------------------------------

Bu yazı ne anlatıyor?

Bu hikaye bir adam ile bir çocuk arasında bir deniz yıldızı hakkında geçen bir konuşmayı anlatıyor.

Aslında bundan ötesini de anlaması mümkün fakat bu biraz daha çaba gerektiriyor. 

Ali R+

Monday, 28 September 2020

Langana-T’de Önemli Bir Adım


Langana-T’de Önemli Bir Adım

Langana-T başlığı altında topladığım Türkçe NLP çalışmamın CORPUS (referans metinler dağarcığı) oluşturma çalışmam 1 milyon kelimeyi aştı.  Langana-T CORPUS’u çeşitli konular ve dönemler Türkçesi içeren 16 kitaptan oluşuyor. Kitapların listesi aşağıda...


Langana-T çerçevesinde yaptığım Türkçe parserın kelime morfolojisi parserında ise başarı oranım %99.98’in üzerinde.  Hata oranı ise % 0.18 yani binde 2’nin altında.  Bu oran çok eski dil kullanan Tanpınar’ın Saatleri Ayarlama Enstitüsünde bile %0.44 yani binde 5’in altında*.


Çalışmamın bu aşamasında kelime morfolojisi parserını iyileştirme işlemini biraz yavaşlatarak cümle morfolojisi için benzer bir başarı yüzdesi yakalama çabasına başlayacağım.  Öncelikle isim, sıfat, zarf gruplamalarının belirlenmesi, daha sonra özne-fiil belirlenmesi ve cümle yapısı kalıplarının dağarcığının oluşturulması...


Yaptığım işin kalitesi daha da yükseltilebilir fakat bu tek kişinin bunların hepsini birlikte yapması açısından imkansız.  Bir TUBITAK desteği alabilmem ve ekip kurabilmem için elinden gelenlerin yardımcı olması dileğimi saygıyla sunarım**.


Ali Riza SARAL


Dip notlar:

**Geliştirmeyi hedeflediğim sistem şu amaçlarla kullanılabilir:

  •           Konu analizi
  •           Çeşitli çok detaylı arama işlemleri
  •           Yüksek duyarlıklı sentiment analizi
  •           Metin karşılaştırma
  •           Bir referans metne göre otomatik soru cevaplama
  •           Türkçe İngilizce tercüme
  •           Log vb uzun yazı metinlerinin güvenlik ve kanun uygulaması için akıllı taranması


*Sistemin bilmediği bir kelime ile karşılaşması durumunda:

  •       Online bir uygulama durumunda kullanıcıya sorarak
  •       Offline ise %0.2 olasılık 90bin kelimelik bir kitapta 180 kelime eder.  Bu ise birkaç saatlik tek kişinin yapabileceği bir düzenleme.
İnceMemed2 108000 26422 % 0.26?
İnceMemed1 86000 21425 % 0.62
İkiŞehir 74000 25608 % 0.66
Hawking 42000 12335 % 0.88
Utopia 51000 18462 % 0.41
Masumiyet 141000 35430 % 0.54
İhtiyarBalıkçı 49000 6830 % 0.61
GarpCephesi 43000 17251 % 0.61
AdımKırmızı 120000 32300 % 0.47
1984 68000 23068 % 0.51
-------------------------
              757000
#words #distinct #NOT FOUND #distinct
words    words roots

Yüzüklerin_Efendisi
Sineklerin_Tanrısı      51759 15204 % 0.19
Savaş_Sanatı_Tzu 31548 11847 % 0.84 (% 0.29 typing mistakes removed)
Saatler_Tanpınar 92382 26135 % 0.44 (old language ... 3dots char mistake)
insanNeileYaşarTolstoy 18093 8775 % 0.27
Huzur_Tanpınar
Gulliverin_Gezileri 72409 23408 % 0.45 (% 0.18 imaginary beings etc. removed)
DokuzuncuHariciye 17747 8192 % 0.78 (old language)
-------------------------------
              283,938
#words #distinct #NOT FOUND #distinct
words    words roots

Saturday, 1 August 2020

LANGANAt de Son Durum

LANGANAt'de Son Durum

State of the Art at LANGANAt morphological parser


Geçmişte bir İngilizce - Türkçe tercüme motoru geliştirme çabalarımı destekleyen herkese teşekkür etmeyi bir borç bilirim.  Malesef, ben işimi bitirmeden önce GOOGLE yeni ber sürüm çıkarda ve ben girişimimi durdurmak zorunda kaldım.  TUBITAK ta bu konuya ilgi gösterebilecek olgunluğa sahip değildi.

I would like to thank all who supported my previous efforts to produce a high quality Englih to Turkish language translator.   Unfortunately, GOOGLE released a new version before I finished my work and I had to stop that endeavour.  TUBITAK was not able to get interested in that subject matter either.


Onun yerine, bir çok amaçla kullanılabilecek Türkçe morfolojik dil parçalayıcı üzerinde çalışmaya başladım.

Instead I began to work on a Turkish morphological language parser which can be used for various purposes.


Bir morfolojik parçalayıcı kelimeleri kök ve olası eklerine ayırır.

Örneğin:

gidiyorum

gitmek + iyor + um  şimdiki zaman 1. şahıs (continuous tense 1st person)


A morphological parser parses words to their root and possible extensions.

For example, the word 'going' is parsed as:

to go + ing continuous tense or gerund


Bir morfolojik parçalayıcı çeşitli amaçlarla kullanılabilir:

1-      Konu analizi

2-      Çeşitli çok detayl ı arama işlemleri

3-      Yüksek duyarlıklı sentiment analizi

4-      Metin karşılaştırma

5-      Bir referans metne göre otomatik soru cevaplama

6-      Türkçe İngilizce tercüme

Log vb uzun yazı metinlerinin güvenlik ve kanun uygulaması için akıllı taranması 

A morphological parser can be used for making:

1- Subject analysis

2- Various types of sophisticated search

3- High precision Sentiment analysis

4- Text compare

5- Automatic question answering based on a reference text

6- Translation

7- Scanning of large texts such as logs for security and law enforcement

Yapay Sinir Ağları teknolojisi ile çoklu ve karışık cümleler yüksek duyarlılıkla işlenememektedir.

%99.5 ‘ten daha başarılı bir kural tabanlı yaklaşım gereklidir.  LANAGANt morfolojik parçalayıcı bu yönde ilk adımdır.

High precision for multiple and complex sentences can not be achieved with Neural Networks.  A rule based approach with higher than %99.5 percent is necessary.  LANGANAt morphological parser is the first step in this direction.

Türkçe kelimeleri güvenilir şekilde parçalamak için gerekli kuralları çıkartacak bir corpus 8metinler dağarcığı) en azından 1 milyon kelimeden oluşabilir.

A corpus for producing the reliable rules to parse Turkish words is probably more than 1 million words. 

 Metin dağarcığının birleşimi de önemlidir.  Eğer metinler belirli bir konu ya da ortamdan geliyorsa parçalayıcının güvenilirliği azalmaktadır.  LANGANAt çeşitli yazarlara ait 15’in üzerinde edebi kitaba dayanacak.  Yazarlar arasındaki dil farkı bileparçalayıcının öğrenmesini ve güvenilirliğini etkileyebilmektedir.

The composure of the corpus is also important.  If texts come from a certain subject area or medium such as Internet the reliability of the parser descreases.   LANGANAt uses more than 15 pieces of literature belonging to various writers.  Even the language difference between writers effects the learning and the reliability of the parser.


Test birden çok alanda yapılmalıdır.

1-      Bulunmayan kelime sayısı

2-      Parçalanan fakat küçük hatalar içeren kelime sayısı

Testing has to be done in more than one areas. 

1- # of words not found

2- # of words parsed but with minor extension mistakes


Test işlemi yeteri kadar büyük metinler üzerinde yapılmalıdır.  Ben 50 bin ile 120 bin kelime içeren metinler kullandım.

Testing has to be done with large enough texts.  I used 50 thousand to 120 thousandwords large texts.


LANGANt bulunmayan kelime sayısı cinsinden %99.5-6 başarılı oldu.  Binde 4-5 hatanın yarısı yazar tarafından kullanılan özel kelimeler ve yanlış yazım vb.’den kaynaklanıyor.

LANGANAt is %99.5-6 succesful in # of words not found is approximately.  Half of this error comes from the special words used by the author and misspellings etc.


LANAGANAt 49 bin kelimelik bir test metninde Parçalanan fakat küçük hatalar içeren kelime sayısı cinsinden % 95-98 arasında bir başarı sağladı.

LANGANAt is %95-98 succesful in # of words parsed but with minor extension mistakes.


Son bir söz, metin parçalayıcılar veya tercüme motorları %85 gibi başarı sonuçları ilan etmekle kalmayıp ilgili test sonuçlarını da açıklamalıdır.

Last but not the least, text parsers or translators should present the test data instead of indicating %85 percents success, very doubtful indeed.


LANGANt has completed more than 430 thousand words

İnceMemed2                    108000  26422

İnceMemed1                    86000   21425

İkiŞehir                                 49000   25608

Hawking                                              42000

Utopia                                  51000

Masumiyet                        141000  35430

İhtiyarBalıkçı                      49000   6830

GarpCephesi                     43000

AdımKırmızı                       120000

1984                                      68000

-------------------------

                757000

İlk sütun kitap içindeki kelime sayısını belirtir.  İkinci sütun Farklı kelime sayısını belirtir, aynı kök fakat farklı ekler dahil.

The first column indicates corpus words ready to be processed.   The second column indicates the number of distinct words that may have same root but different extensions.


There will be a 250 tousand words testing data that has to be prepared.

Yaklaşık 250 bin kelimelik bir corpus arttırımı yapacağım.


Bu çalışma çok bu aşamada yüksek bir teknoloji içermese de büyük bir emek zorunlu.

This is a not very high tech but highly reliable approach that requires a lot of labour. 


İki Şehirin Hikayesi ile ilgil yaptığım çalışmanın sonuçlarına sourceforge'tan ulaşabilirsiniz.

You can reach the outputs of my work on İki Şehrin Hikayesi at sourceforge:


https://sourceforge.net/projects/turkishlanguageparser/files/iki__sehirin_hikayesi/


Thursday, 12 March 2020

A Simple Algorithm for Automatic Answering


A Simple Algorithm for Automatic Answering

First of all a morphological and syntactical parse of the text must be done.  The parse should also make grammatical parsing including the subject-object determination.  I will assume these are done correctly given the text below.

Ali Ankara’ya gitti. Ali okula gitti. Ayşe okula gitti. Ali yemek yedi.

There must be an episodic memory which keeps the sentences as:

SentenceNo  1: Ali Ankara’ya gitti.
Sentence No 2: Ali okula gitti.
Sentence No 3: Ayşe okula gitti.
Sentence No 4: Ali yemek yedi.

There must be a semantical memory to which the items in these sentences are attached, such as Ali, Ayşe, okul, gitmek, etc. as seen in figure 1.  To these items, their occurence numbers as they appear in which sentences are attached.


Figure 1.

This structure must be built when the reference text is given.  Afterwards when the question is asked the question must be parsed similarly as seen in Figure2.

Figure 2.


The answer of the question is given from all the possible deepst common child leaves. That is sentence 1 and 2:
SentenceNo  1: Ali Ankara’ya gitti.
Sentence No 2: Ali okula gitti.


An other example question:

Figure 3.


The answer is sentence 2 and 3, that is:
Sentence No 2: Ali okula gitti.
Sentence No 3: Ayşe okula gitti.

More importantly:  If the semantic tree is well developed this structure can answer more abstract questions such as:
Kim hareket etti?
Ali ne yaptı?

Cheers.

Ali Riza SARAL

Thursday, 30 January 2020

LANGANAt: Yaşar Kemal Ince Memed 2 morphologic analysis

Yaşar Kemal Ince Memed 2 morpholojik analizi

Cümle sayısı: 15463
Kelime sayısı: 108899
Tekrarlanmamamış Özgün kelime sayısı: 25209
Kelime ortalama tekrarı: 4
Fiil sayısı(aynı fiilin tüm çekimleri dahil): 9254
Fiil kök sayısı(-mak -mek):122
Fiil sayısı(sorunlu olabilir): 113
Zamir sayısı: 261
Zarf sayısı: 805
Sıfat sayısı: 3098
İsim sayısı: 8623
Edat sayısı: 33
Bağlaç sayısı: 55
Ünlem: 15
Özel İsim: 672 ?
NOT FOUND sayısı(sözlükte bulunamayan): 1710

https://sourceforge.net/projects/turkishlanguageparser/files/Turkish%20Parser/InceMemed2_MORPHOLOGIC_analysis.txt/download


Saturday, 4 January 2020

Yazılım Mühendislerinin İşe Alımı İnceleme Süreci


Yazılım Mühendislerinin İşe Alımı İnceleme Süreci üzerine bazı Düşünceler

2019 sonlarında uluslararası bir inceleme şirketi(Vetting Company) ile tanıştım. Hindistan’da bulunan biriyle interview’um yapıldı.  Daha sonra LA’de içlerinde ekip liderininde bulunduğu 6 inceleme elmanı ile birtoplantuya katıldım.  Interview içeriği ve yapısı ile ilgili samimi fikirlerimi onlara sundum.
İşte konu ile ilgili görüşlerim.

Kişisel ortam:
  •                      Programcının kişisel bilgisayar ortamının nasıl düzenli olduğunu kontrol ediniz.
  •                    Gruplama yoğunluğu ve unsurların kalitesini kontrol ediniz.


Daha önce yapılmış işler:
  •                     Adayın daha önce yapmış olduğu işleri sorunuz.   
  •                   Bunların gerçek olup olmadığını örnekler ve kodlar üzerinde sorular sorarak kontrol ediniz. 
  •                   LOC ve istatistik bilgilerini, bunlar üzerinde kaç kişi çalıştığını ve bitirmek için adayın ne kadar zamanını aldığını sorunuz.
  •                  Kullanılmış dokümantasyon sistemini ve Yazılım Döngüsünü (Software Lifecycle) sorunuz. Comment’leri ve diğer belgeleme örneklerini kontrol ediniz.


Öğrenme eğrisi testi:
  •                     Adaya hangi programlama dillerini kullanmış olduğunu sorunuz.
  •                   Aday için en uygunu olmayan birini seçiniz.
  •                   Adaydan internet referanslarından faydalanarak bu dil ile basit bir program yazmasını  isteyiniz.
  •                Ne kadar zaman aldığını ve ne kadar kaliteli sonuç aldığınızı kontrol ediniz.


Hata bulma yetenek testi:
  •                     Değişen zorluklarda hatalı programlar hazırlayınız.
  •                   Adayın bunları çözüp çözemediğini ve ne kadar zamanda çözdüğünü kontrol ediniz.


Kopyalama/Geliştirme yetenek testi:
  •                     Sorunlara yaklaşım biçiminizi yansıtan, şirketinize/projeye ait templateler üretiniz.
  •                   Adayın bu templateleri kullanarak küçük bir çözüm üretmesini isteyiniz.


Test yapma yetenek testi:
  •                      Adayın daha önce kullanmış olduğu bir test sürecini isteyiniz.
  •                 Verdiğiniz bir program için adayın bir test prosedürü geliştirmesini isteyiniz. 


Thursday, 2 January 2020

Vetting process for recruitment of Software Engineers

Some ideas on the Vetting process for recruitment of Software Engineers

Recently I met with an international vetting company. I got an interview with somebody in India and then I attended a meeting with 6 vetting professionals from LA including their leaders. I offered them my sincere views about the interview and its design. Here are my opinions on the subject.

Personal environment:
  • Check how is the programmer’s personal computer environment organise.
  • Check grouping density and quality of items


Previous works:
  • Ask for examples of previous work’s of the candidate. 
  • Check whether they are true examples by asking questions about the examples. 
  • Ask LOC and other statistics information including how many people has worked on them and how long did it take them and the specific candidate to finish it.
  • Ask for the documentation process and the Software lifecycle used.  Check the comments and other documentation examples.


Learning curve test:
  • Ask the candidate which programming languages he/she has used.
  • Choose one that is not the best for the candidate.
  • Ask him/her to write a simple program in that language using internet as a reference.
  • Check how long and how good it takes.


Diagnosing ability test:
  • Produce faulty programs with varying difficulty.
  • Check if/how long the candidate can fix them. 

Copying/developing ability test
  • Produce company templates which characterize how your company approaches to specific problems.
  • Require the candidate to develop a small solution using these templates
Testing ability test
  • Ask for a test process the candidate has used in prev work
  • Require the candidate to produce a test method for a given program


Saturday, 7 December 2019

NetBeans RESTful example CustomerDB does notwork


NetBeans RESTful example CustomerDB does not work


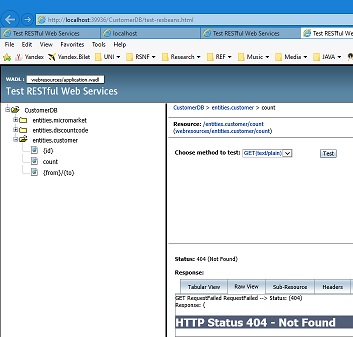
NetBeans 8.1 New Project->Samples->WebServices->REST:CustomerDB(JAVAEE6) example does not work.
1-      First of all you have to make sure that the Derby database is working.
Select from Services menu->Databases->jdbc:derby://localhost:1527/sample[app on APP]
User = app pwd=app (in my case) (user and pwd must be the same, just type the uid to pwd)
2-      Select from services Menu->Servers->GlassFish Server and right click->Start
3-      After starting the server from Projects Menu Clean and Build CustomerDB.
4-      Select Deploy customerDB by rightclick on CustomerDB
5-      Select and run CustomerDB->js->testresbeans.html


6-      Select RESTful Web Services->CustomerFacadeREST with rightclick select Test ResourceUri

7-      This means the RESTful side is working.  But there is probably something wrong in the URI.
8-      Put an alert before:
alert(req); //ARSSSSSSSSSssssssssssssssss
        if(method == 'POST') {
            c = this.xhr.post(req, mimetype, params);
        } else if(method == 'PUT') {
            c = this.xhr.put(req, mimetype, params);
        } else if(method == 'GET') {
            c = this.xhr.get(req);
            //c = this.xhr.get(req, mimetype);
        } else if(method == 'DELETE') {
            c = this.xhr.delete_(req);
        }
9-      Yes, the URI is distorted.

10-   In order to locate the mistake:
var req;
        alert(path);//ARSSSSSSSSSssssssssssssssss
        alert(baseURL);//ARSSSSSSSSSssssssssssssssss
        if( ts.isURL(path) )
            req = path;
        else
            req = baseURL+escape(path);  // ARSSSSSSSSS
       
        //change url if there are template params
        if(tparams != null) {

11-   Temporary solution is:
var req;
        alert(path);//ARSSSSSSSSSssssssssssssssss
        alert(baseURL);//ARSSSSSSSSSssssssssssssssss
        if( ts.isURL(path) )
            req = path;
        else
            req = path;
            //req = baseURL+escape(path);  // ARSSSSSSSSS